 AegisX
核心要点(TL;DR)
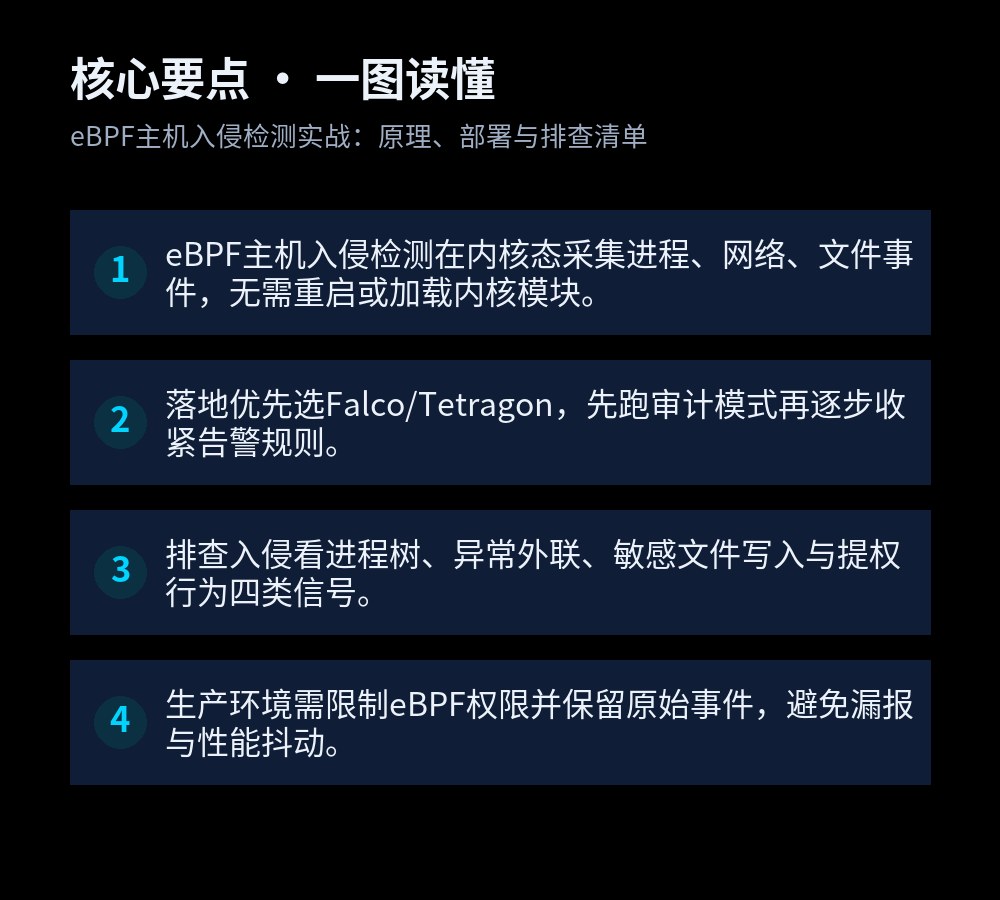
- eBPF主机入侵检测在内核态采集进程、网络、文件事件,无需重启或加载内核模块。
- 落地优先选Falco/Tetragon,先跑审计模式再逐步收紧告警规则。
- 排查入侵看进程树、异常外联、敏感文件写入与提权行为四类信号。
- 生产环境需限制eBPF权限并保留原始事件,避免漏报与性能抖动。
服务器被入侵时,传统HIDS往往要等日志落盘、轮询比对后才告警,攻击者早已完成提权与外联。eBPF主机入侵检测把探针下沉到内核,实时捕获进程、网络与文件行为,让运维在攻击链早期就能发现异常。本文从原理到落地,给出可直接执行的命令、规则与排查清单,帮助你在不重启业务的前提下构建内核级安全监控。
一、eBPF主机入侵检测是什么:为什么它更适合现代主机
eBPF(Extended Berkeley Packet Filter)是Linux内核提供的一种安全、可编程的执行引擎。它允许用户态程序把经过验证的字节码挂载到内核钩子点,如系统调用、网络协议栈、文件系统函数,从而在不修改内核源码、不加载内核模块的情况下采集事件。
与传统HIDS相比,eBPF主机入侵检测有三个关键差异:
- 实时性:事件在内核态产生即被捕获,延迟通常在毫秒级,而审计日志轮询可能延迟数秒到数分钟。
- 抗绕过:探针位于内核,用户态恶意程序难以关闭或篡改;传统基于用户态Agent的检测容易被kill。
- 低开销:通过过滤与聚合,只把关键事件送到用户态,避免全量日志带来的I/O压力。
它特别适合云主机、容器节点与高并发Web服务器,因为这些场景下攻击面大、日志量大,传统方案容易漏报或拖慢业务。
二、原理与危害:攻击者在内核眼里留下了什么痕迹
无论攻击者用什么语言写恶意程序,最终都要通过系统调用与内核交互。eBPF主机入侵检测正是抓住这一点,监控以下关键行为:
| 攻击阶段 | 典型行为 | 可监控的eBPF钩子 |
|---|---|---|
| 初始访问 | Web服务派生Shell、下载恶意脚本 | execve、connect |
| 权限提升 | setuid、capset、写入sudoers | setuid、capset、openat |
| 持久化 | 写crontab、SSH密钥、systemd服务 | openat、write |
| 横向移动 | 扫描内网、连接非业务端口 | connect、socket |
| 数据外传 | 连接矿池、C2域名、大流量上传 | connect、sendmsg |
如果缺少eBPF主机入侵检测,这些行为可能只散落在auditd或应用日志中,难以关联成完整攻击链。攻击者常通过删除日志、替换二进制来掩盖痕迹,而内核态事件更难被清除。
三、环境准备与工具选型:先跑起来再调优
在部署前,先确认内核与权限。eBPF需要Linux 4.9以上,推荐5.4+以获得更完整的钩子支持。执行以下命令检查:
uname -r
cat /proc/sys/kernel/unprivileged_bpf_disabled
mount | grep bpf
如果输出显示内核版本低于4.9,或bpf文件系统未挂载,需要先升级内核或挂载:
mount -t bpf bpf /sys/fs/bpf工具选型上,开源方案推荐Falco与Tetragon。Falco规则生态成熟,适合快速上手;Tetragon基于eBPF,支持进程执行与网络策略,适合Kubernetes环境。安装Falco的典型步骤:
- 添加官方仓库并安装:
curl -s https://falco.org/repo/falcosecurity-packages.asc | apt-key add - - 安装驱动或使用eBPF探针:
apt install falco,在配置中设置engine.kind: ebpf。 - 启动服务:
systemctl enable --now falco。 - 查看事件:
journalctl -fu falco。
首次部署建议先开启审计模式,只记录不阻断,避免误杀业务。
四、规则编写与告警验证:用最小规则抓住高危行为
规则是eBPF主机入侵检测的核心。以Falco为例,一条检测“Web服务派生Shell”的规则可以这样写:
- rule: Web Shell Spawned
  desc: Detect shell spawned by web server
  condition: spawned_process and proc.pname in (nginx, apache2, httpd) and proc.name in (bash, sh, zsh)
  output: "Web shell spawned (user=%user.name command=%proc.cmdline parent=%proc.pname)"
  priority: CRITICAL
  tags: [host, container, mitre_execution]
编写规则时遵循三个原则:
- 白名单优先:把已知的运维脚本、备份任务加入例外,减少噪音。
- 关注进程树:父进程与子进程的组合比单个进程名更可靠。
- 分级告警:CRITICAL立即通知,WARNING汇总日报。
验证规则是否生效,可以手动模拟攻击行为:
# 模拟Web服务派生Shell
sudo -u www-data bash -c 'id'
# 模拟写入SSH密钥
echo test >> /root/.ssh/authorized_keys
然后在Falco日志中确认是否产生对应告警。若没有,检查规则条件、探针状态与事件丢失指标。
五、排查清单:发现告警后按这四步走
收到eBPF主机入侵检测告警后,不要急于重启服务器。按以下清单排查,既能保留证据,又能快速定位:
- 确认进程树:用
ps -ef --forest或pstree -p查看告警进程的父进程与启动时间,判断是否由Web服务或计划任务派生。 - 检查网络外联:用
ss -antp或lsof -i查看异常连接,重点关注矿池端口、陌生IP与高频短连接。 - 检查敏感文件:用
find /etc /root -mtime -1 -type f查看最近修改的配置与密钥文件,重点看/etc/passwd、/etc/crontab、~/.ssh。 - 保留现场:导出告警事件、进程内存与相关日志,再决定是否隔离主机。切勿直接删除可疑文件,以免丢失IOC。
如果确认是入侵,立即隔离网络、轮换密钥,并检查同网段其他主机是否被横向移动。
六、防护建议与行动清单
eBPF主机入侵检测不是一次性部署,而是持续运营。建议按以下行动清单推进:
- 第一周:在测试机部署Falco或Tetragon,开启审计模式,观察误报。
- 第二周:编写并调优5到10条高危规则,覆盖反弹Shell、提权、敏感文件写入与外联。
- 第三周:接入告警通道,设置分级通知,并保留原始事件至少30天。
- 持续:每月回顾规则命中率,更新白名单,关注内核与工具版本升级。
如果团队缺乏自建精力,可以关注AegisX(神盾X)在主机安全方面的能力,其内核级监控与告警联动可与现有eBPF方案互补,降低运营门槛。无论选择哪种方案,核心都是把检测前移到内核层,让攻击者在系统调用阶段就暴露行踪。
常见问题(FAQ)
eBPF主机入侵检测和传统HIDS有什么区别?
传统HIDS多依赖用户态轮询、审计日志或文件完整性校验,存在延迟高、易被绕过、性能开销大等问题。eBPF主机入侵检测直接在内核态挂载探针,实时捕获系统调用、网络连接与文件操作,具备低延迟、低开销、难以被用户态恶意程序关闭的优势,更适合云原生与高并发场景。
生产服务器上跑eBPF会不会导致内核崩溃或性能下降?
不会直接导致内核崩溃。eBPF程序在加载前会经过内核验证器严格检查,确保不会死循环或越界访问。性能方面,合理编写与过滤规则后开销通常很小,但应避免在热点路径上采集过多事件。建议先在测试环境压测,再灰度到生产,并监控CPU与丢包指标。
没有安全团队,运维如何快速用eBPF做入侵检测?
可以从Falco或Tetragon入手,使用官方规则集并开启审计模式,只记录不阻断。先关注反弹Shell、敏感文件写入、异常外联三类高危行为,再根据业务白名单逐步调优。配合系统日志与告警通道,运维也能在数小时内搭建基础检测能力。
eBPF检测规则应该重点监控哪些行为?
重点监控四类:一是进程创建异常,如Web服务派生Shell;二是网络外联异常,如非业务端口连接矿池;三是文件写入异常,如修改/etc/passwd或SSH密钥;四是权限提升异常,如setuid与capability变更。围绕这四类编写规则,能覆盖大多数主机入侵场景。
eBPF主机入侵检测能否覆盖容器环境?
可以。eBPF探针在内核层工作,天然能看到容器内进程的系统调用,只需在规则中关联容器ID、镜像与命名空间即可。相比仅监控宿主机,容器场景要额外关注逃逸行为,如挂载宿主机目录、访问Docker socket与特权容器启动。