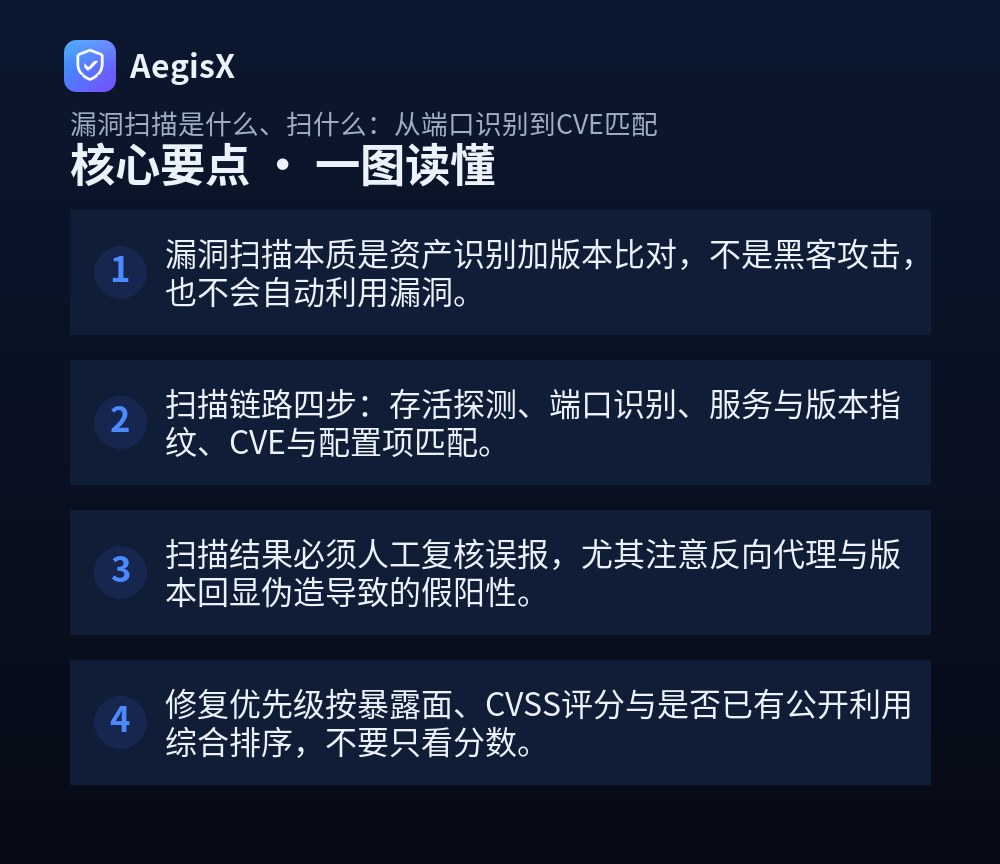
核心要点(TL;DR)
- 漏洞扫描本质是资产识别加版本比对,不是黑客攻击,也不会自动利用漏洞。
- 扫描链路四步:存活探测、端口识别、服务与版本指纹、CVE与配置项匹配。
- 扫描结果必须人工复核误报,尤其注意反向代理与版本回显伪造导致的假阳性。
- 修复优先级按暴露面、CVSS评分与是否已有公开利用综合排序,不要只看分数。
为什么你扫了一堆漏洞,却依然被攻破
很多运维同学第一次跑完漏洞扫描,拿到一份几十页的报告:高危三十个、中危上百个,然后……就没有然后了。报告躺在共享盘里,直到某天某个未打补丁的中间件被利用。问题不在扫描工具,而在于大多数人并不清楚漏洞扫描是什么、扫的到底是什么,自然也无法把结果转成修复动作。本文按扫描器的真实工作链路拆解:从端口识别到 CVE 匹配,每一步给出可执行命令和判读方法,让你能把报告变成补丁清单。
漏洞扫描到底扫什么:四步链路拆解
漏洞扫描不是"黑进服务器",它本质上是资产识别 + 版本比对。主流扫描器(Nmap、Nuclei、OpenVAS、Nessus)都遵循同一条链路:
- 存活探测:确认 IP 是否在线,常用 ICMP、TCP SYN 或 ARP。
- 端口识别:找出对外开放的 TCP/UDP 端口,确定攻击面。
- 服务与版本指纹:通过 banner、响应特征推断服务类型和版本号。
- CVE 与配置项匹配:把版本号、响应特征对照漏洞库,命中即报。
关键认知:扫描器只能看到"暴露出来的东西"。一个只在内网监听、未对扫描源开放的端口,扫描结果里完全不存在,但它照样可能被打穿。所以扫描前必须先确认资产清单与扫描源位置。
第一步:端口识别,先摸清暴露面
用 Nmap 做一次快速全端口探测,先拿到端口清单再谈漏洞:
nmap -Pn -sS -p- --min-rate 2000 --max-retries 1 -oA scan_ports 10.0.0.0/24判读要点:-Pn 跳过 ICMP 探测,避免被禁 ping 的主机漏掉;-sS 半开扫描更快但需 root;-p- 扫全 65535 端口,只扫常见端口是漏报的头号原因。拿到开放端口后,再做版本指纹:
nmap -Pn -sV -sC -p 22,80,443,3306,6379,8080 -oA scan_finger 10.0.0.10-sV 探测服务版本,-sC 跑默认脚本(含部分弱口令与配置检查)。输出里的 Service Info 就是后续 CVE 匹配的输入。
第二步:服务指纹的可靠性陷阱
版本号是扫描结论的根基,但它经常不可信。常见失真场景:
- Nginx 反代后端的 Tomcat,扫描器看到的是 Nginx 版本,后端漏洞被掩盖。
- 运维为"安全"改了 banner,扫描器识别成不存在的版本,产生误报。
- 容器基础镜像版本与实际运行组件不一致。
因此对关键服务要人工确认,例如登录服务器执行 nginx -v、redis-server --version、mysql --version,与扫描结果交叉验证。
第三步:CVE 匹配与配置类检测
拿到版本后,扫描器会与漏洞库比对。以 Nuclei 为例,可按模板做定向验证,比全量扫描更快定位:
nuclei -u https://example.com -t cves/ -t exposures/ -severity critical,high -o nuclei_result.txtOpenVAS/GVM 则通过 gvm-cli 或 Web 控制台创建任务,建议先建"发现型"策略(只做端口与服务识别),再建"全量检测"策略,避免一次性高强度扫描打挂业务。配置类问题同样重要:Redis 未授权、MySQL 空口令、目录列表开启,这些往往没有 CVE 编号,却是真实入侵入口。
误报复核清单:别急着提工单
扫描报告里的高危,至少三成需要人工复核。按下面清单逐项过:
| 复核项 | 操作 | 结论判定 |
|---|
| 版本是否真实 | 登录主机执行版本命令 | 与报告不一致即误报 |
| 端口是否真实开放 | ss -lntp 对照 | 仅内网监听则风险降级 |
| 漏洞是否可达 | 确认前置认证/WAF 拦截 | 需认证才可利用则降级 |
| 是否有公开 EXP | 查厂商公告与利用状态 | 已有在野利用则升级 |
复核后把结果分成三类:确认存在、疑似存在需复测、误报并记录原因。误报原因要沉淀成规则,下次扫描直接过滤,否则团队会逐渐无视报告。
修复优先级:不只看 CVSS 分数
排序建议用三维度加权:暴露面(公网 > 内网 > 本地)、CVSS 评分、是否已有公开利用。公网可达 + 已有 EXP 的漏洞,即使 CVSS 只有 7 分也应立即处理;纯内网、需高权限才可利用的 9 分漏洞可排入常规窗口。
经验法则:能被匿名访问的入口漏洞,修复窗口按小时算;需要登录或内网条件的,按周算。
修复动作优先选升级版本或关闭服务,其次才是加 WAF 规则临时缓解。缓解措施必须登记到期时间,否则会变成永久性技术债。在边界防护层面,AegisX 的 Web 防火墙与资产暴露面监测能力可以在补丁窗口期提供虚拟补丁与端口收敛告警,作为过渡手段使用。
行动建议:把扫描变成例行流程
- 建立资产清单,新增资产上线前必须扫描,下线资产及时剔除。
- 互联网暴露面每周全量、每日增量;内网每月一次;重大漏洞披露后 24 小时内专项扫描。
- 扫描前通知业务方、避开高峰、限制并发,生产环境准备回滚预案。
- 报告必须走"复核—定级—派单—验证"闭环,修复后用同一模板复测确认。
- 把误报原因和放行规则写进文档,保持扫描结果的可信度。
漏洞扫描的价值不在于报告有多厚,而在于你能不能在下次攻击前,把清单上的第一项真正关掉。
常见问题(FAQ)
漏洞扫描和渗透测试有什么区别,两个都要做吗?
两者目标不同,不能互相替代。漏洞扫描是自动化、广覆盖、可高频执行的资产与版本比对,擅长发现已知CVE和配置缺陷;渗透测试是人工按攻击链验证可利用性,能发现逻辑漏洞和组合风险。建议先做扫描建立基线并持续巡检,再对核心系统定期做渗透测试验证真实风险。
扫描器报了一堆高危,是不是服务器已经被入侵了?
不是。漏洞扫描只证明目标版本或配置存在匹配特征,并不代表漏洞已被利用。判断是否失陷要看日志、进程、异常外连和文件完整性。正确做法是先复核误报,确认漏洞真实存在后按暴露面排序修复,同时对已确认被利用的迹象做应急排查。
内网服务器需要做漏洞扫描吗?
需要。大量入侵是攻击者先拿下边界一台机器后横向移动,内网未打补丁的老旧服务正是跳板。建议对办公网与生产网分别建立扫描策略,内网可降低扫描频率但必须覆盖,重点检查弱口令、未授权访问和过期中间件版本。
扫描会不会把业务扫挂,怎么降低风险?
高强度扫描确实可能触发WAF封禁、拖慢老旧设备或导致脆弱服务崩溃。建议先在测试环境验证策略,生产环境避开业务高峰、限制并发与超时,禁用破坏性插件,扫描前做好快照与回滚预案,并提前通知业务方。
多久扫一次比较合理?
按资产变更节奏定。互联网暴露面建议每周一次全量加每日增量,内网每月一次,重大漏洞披露后24小时内做专项扫描。新增资产上线前必须扫描,关闭或变更的资产及时从清单移除,避免长期积累无效告警。